毕业答辩选题调整论证 以“基于大数据的农产品交易数据分析与可视化系统”为例
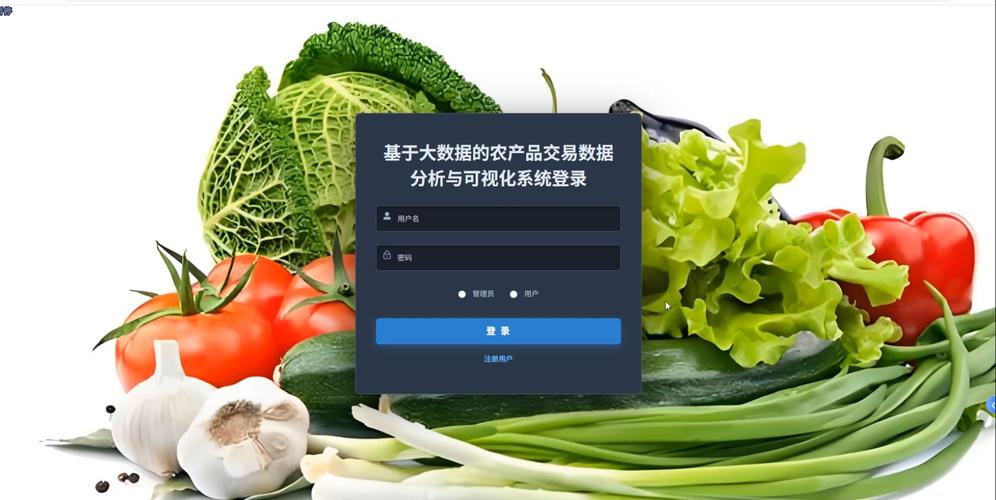
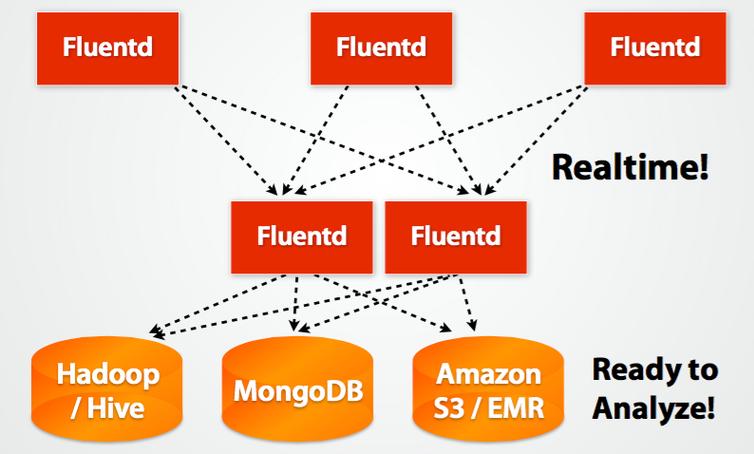
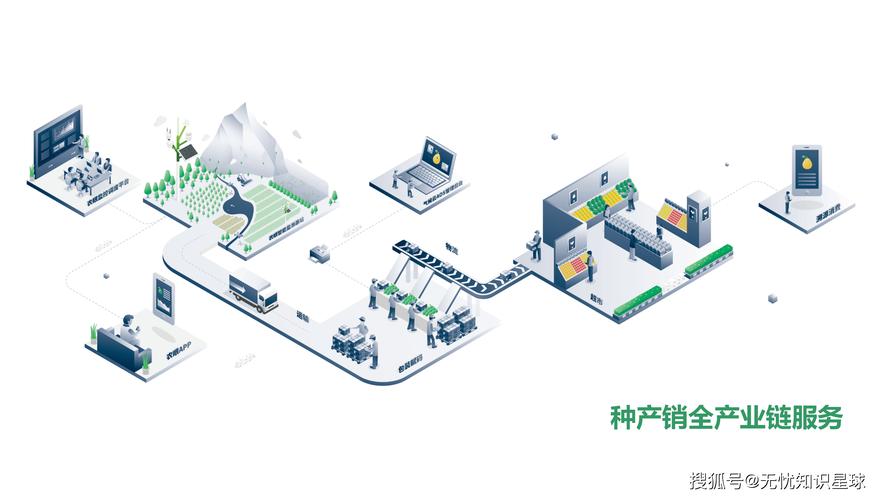
一、问题背景与核心质疑\n\n在毕业答辩环节,评审教师对“基于大数据的农产品交易数据分析与可视化系统”这一选题提出“选题不当”的质疑,出发点通常并非否定农产品交易数据分析本身的价值,而是批评该选题与“大数据”方向之间存在明显的名实不符。具体而言,质疑集中在三个层面:其一,所谓“大数据”是否具有真实的规模、多样性和实时性特征;其二,系统是否采用了大数据技术栈而非传统关系型数据库加可视化图表;其三,研究问题是否足够聚焦,能否形成可验证的学术贡献。\n\n二、大数据的内涵与农产品交易数据的边界条件\n\n讨论选题是否成立,首先需要回到“大数据”的界定。学术与工业界通常以规模性、多样性、高速性、价值密度低和真实性等特征来描述大数据。在农产品交易场景中,名义上存在多源、多年、多品类的交易数据,但学生可获取的数据集往往依赖公开统计年鉴、电商平台页面采集或模拟生成,样本量普遍在数十万至百万条级别,结构接近规整的一维或二维表,更新频率有限。这类数据在规模上更接近“中等数据”,在多样性上缺乏传感、物流、气象、图像等异构数据的融合,在高速性上不具备流式接入或实时处理需求。\n\n如果系统核心仅是将统计报表转化为折线图、柱状图和地图,所用技术为关系型数据库、单机Excel或轻量前端可视化库,那么大数据的标注就沦为蹭热点的修辞。此时选题判为“不当”并无不妥——准确地说,是称谓不当、问题不当和贡献边界不当。\n\n三、选题的合理化路径与实验证明设计\n\n若希望保留农产品交易数据分析的背景,同时使选题具备正当性,有两种调整策略。第一种强调真实的数据聚合过程和分布式数据分析的设计必要性。可以将研究约束为:生成不低于数千万行、多源异构的成交记录与关联字段(商户属性、产地、物流时效、营销事件等),构建从数据接入、清洗、维度建模到指标计算的管道;分布式框架用于示范和分析代价来源。关键在于,必须先进行代价度量以证明“不借助分布式与流水线就不可行”,例如对比不同数据规模和维度数量时的连接与漏斗分析计算成本与稳定性,否则大数据标注的前提并不成立。第二种路径则将大数据要求收紧,规范为“农产品交易管理与可视化仿真”,在大数据相关课程和答辩要中做到口径干净,避免造成小数据集必须使用重型框架的伪需求;亦可对标应用软件(网页/原型)认可度进行分析和实践。无论采用哪一词路,都必须补一整节量化的基线测量与分析说明,以此替代口头申辩。对当前已给出“入选不当”评审结论的任务来说,申辩如果不能对应超大规模下的有效性限界和历史评价差异(而非平台堆砌),完整的大数据硕士课题定位就无可挽回.\
如若转载,请注明出处:http://www.jianqunge168.com/product/38.html
更新时间:2026-11-01 02:21:24